
Товарный фид интернет-магазина: почему каталог теперь должен быть понятен не только покупателю
Раньше каталог интернет-магазина создавали прежде всего для двух участников: покупателя и поискового робота.
Покупателю нужны понятные названия, фотографии, характеристики, цена и наличие.
Поисковой системе — страницы, которые можно проиндексировать.
В 2026 году этой схемы уже недостаточно.
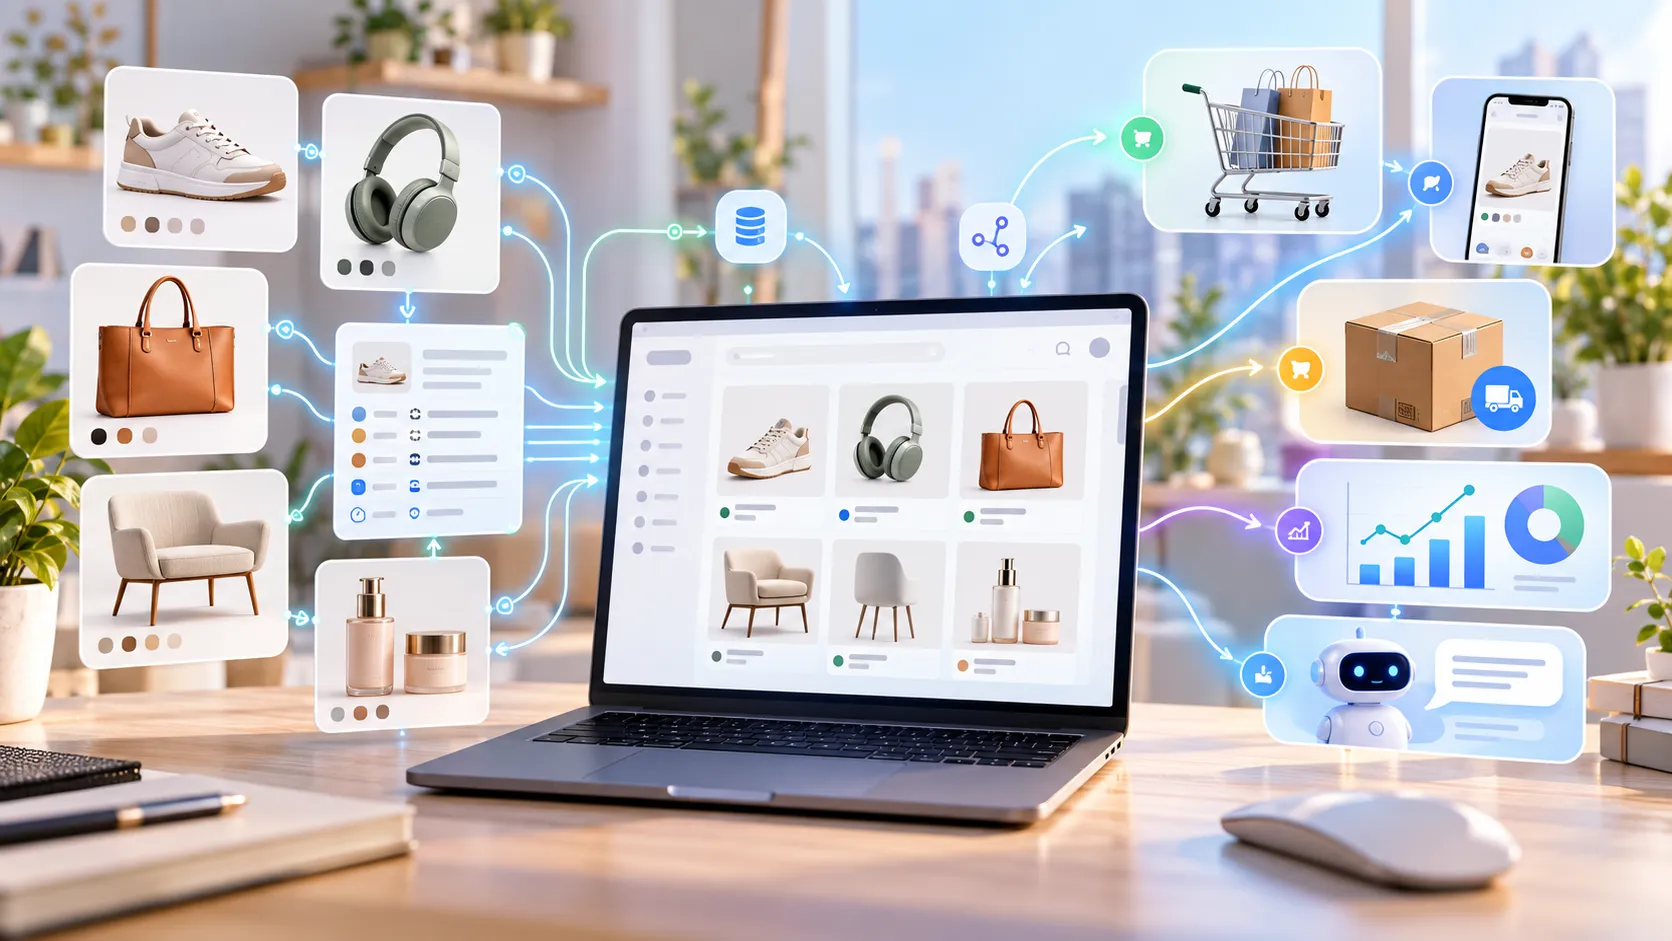
Между интернет-магазином и покупателем появилось гораздо больше систем: товарный поиск, рекламные платформы, маркетплейсы, сервисы рекомендаций, мобильные приложения и AI-помощники.
И всем им нужны данные о товарах.
Не красивый дизайн карточки.
Не рекламный баннер.
А структурированная информация:
что это за товар, сколько он стоит, есть ли он в наличии, к какой категории относится, какие у него характеристики и где его можно купить.
Одним из способов передавать такую информацию становится товарный фид.
И постепенно он превращается из технического файла «для рекламы» в важную часть инфраструктуры интернет-магазина.
Что такое товарный фид
Товарный фид — это структурированный файл или поток данных, содержащий информацию о товарах интернет-магазина.
Проще представить его как каталог, предназначенный не для человека, а для другой информационной системы.
В нём могут передаваться:
идентификатор товара;
название;
описание;
категория;
производитель;
артикул;
цена;
старая цена;
валюта;
наличие;
количество;
ссылка на товар;
изображения;
характеристики;
варианты товара;
условия доставки.
Конкретный набор полей зависит от системы, которой предназначен фид.
Например, Яндекс использует формат YML — собственный стандарт на основе XML. Через такой файл интернет-магазин может передавать информацию о каталоге в Яндекс Товары и другие сервисы экосистемы.
Но сама идея гораздо шире YML.
Товарные данные могут передаваться через XML, CSV, JSON, API или специализированный формат конкретной платформы.
Поэтому фид — это не конкретный тип файла. Это способ регулярно передавать структурированный каталог из одной системы в другую.
Зачем нужен фид, если товары уже есть на сайте
Логичный вопрос.
У каждого товара уже есть страница.
На ней написано название, показана фотография, указана цена.
Почему внешняя система не может просто открыть страницу и прочитать всё самостоятельно?
Может.
И поисковые роботы именно так работают много лет.
Но между обходом сайта и прямой передачей данных есть существенная разница.
Представим, что утром цена товара составляла 9 990 ₽, а после обеда изменилась до 8 490 ₽.
Страница интернет-магазина обновилась сразу.
Поисковый робот может вернуться на неё через несколько часов или дней.
Фид же можно генерировать регулярно и передавать актуальное состояние каталога значительно быстрее.
То же самое относится к наличию.
Товар закончился, но внешняя система ещё показывает его как доступный.
Покупатель переходит в магазин и обнаруживает:
«Нет в наличии».
Для пользователя это плохой опыт.
Для магазина — бесполезный переход.
Поэтому задача фида не просто перечислить товары.
Его задача — синхронизировать состояние каталога с внешними каналами.
Где используются товарные фиды
Когда говорят о фидах, первым обычно вспоминают рекламные системы и маркетплейсы.
Но область применения гораздо шире.
Фид может использоваться для:
товарного поиска;
динамической рекламы;
маркетплейсов;
сервисов сравнения цен;
рекомендательных систем;
мобильного приложения;
партнёрских площадок;
AI-сервисов.
Фактически один каталог интернет-магазина постепенно становится источником данных для множества каналов.
Это меняет сам подход к его устройству.
Каталог больше нельзя считать просто набором страниц сайта.
Это база товарных данных, из которой создаются разные представления.
Яндекс тоже получает товары не только со страниц сайта
Для российского интернет-магазина хороший пример — Яндекс.
Яндекс Товары позволяет передавать каталог через YML-фид.
В нём магазин описывает свои предложения: название, цену, валюту, изображения и другие параметры.
По данным документации Яндекса, информация о товарах для поисковых представлений может поступать как из загруженных фидов, так и со страниц сайта через микроразметку.
То есть поисковая система использует сразу несколько источников.
Это важный момент.
Не стоит рассматривать SEO карточки товара, микроразметку и товарный фид как конкурирующие способы.
Они дополняют друг друга.
Страница нужна покупателю и поисковой индексации.
Микроразметка помогает машине понять содержимое страницы.
Фид позволяет регулярно передавать структурированное состояние каталога.
В 2026 году появился ещё один получатель товарных данных — AI
Самое интересное изменение происходит за пределами классического поиска.
Покупатель всё чаще может начать выбор товара не с каталога магазина и даже не с обычной поисковой строки.
Запрос может выглядеть так:
«Найди беспроводные наушники до 15 000 рублей с хорошим шумоподавлением и автономностью больше 30 часов».
AI-система должна не просто найти страницы со словами «беспроводные наушники».
Ей нужно сопоставить множество параметров:
цена;
тип товара;
характеристики;
наличие;
варианты;
предложения разных продавцов.
Именно здесь структурированные товарные данные становятся особенно ценными.
В 2026 году OpenAI расширила товарный поиск в ChatGPT и описала механизм, при котором продавцы могут предоставлять данные каталога через product feeds.
Это важный сигнал для всего e-commerce.
AI-поиск постепенно становится ещё одним каналом обнаружения товаров.
А значит, интернет-магазину нужно думать не только о том, как выглядит карточка, но и о том, насколько хорошо товар описан как данные.
Хороший фид начинается не с XML
Здесь возникает распространённая ошибка.
Кажется, что для хорошего товарного фида достаточно установить модуль, который сформирует XML.
Но генератор не может исправить плохой каталог.
Если в интернет-магазине товар называется:
«Модель 3482 чёрный»
то примерно такое же название попадёт и во внешний канал.
Если производитель записан в названии, но отсутствует в отдельном поле, системе сложнее понять бренд.
Если цвет хранится только внутри описания, его нельзя надёжно использовать как характеристику.
Если разные варианты товара заведены хаотично, проблема уйдёт дальше по цепочке.
Фид отражает качество исходных данных.
Поэтому работа начинается не с экспорта.
Она начинается со структуры каталога.
У каждого товара должен быть стабильный идентификатор
Один из самых недооценённых элементов товарной интеграции — ID.
В интернет-магазине товар уже имеет внутренний идентификатор.
Но при передаче во внешние системы важно, чтобы идентификатор оставался стабильным.
Сегодня товар отправился как:
1257
Завтра он не должен неожиданно превратиться в:
product-new-9834
только потому, что изменилась логика генерации файла.
По ID внешняя система понимает, что перед ней тот же самый товар, у которого просто изменилась цена или наличие.
Особенно это важно, когда один каталог одновременно используется в нескольких каналах.
Стабильность идентификаторов облегчает синхронизацию, аналитику и обновления.
Название товара должно описывать товар
Внутри магазина иногда встречаются названия вроде:
«Хит продаж!!!»
«Новинка»
«Арт. 48292»
«Модель №17»
Человеку, знакомому с каталогом, может быть понятно, о чём речь.
Внешней системе — нет.
Хорошее название помогает определить сам товар.
Например:
Беспроводные наушники SoundPro X5, чёрные
намного информативнее, чем:
SoundPro X5
Это не означает, что нужно превращать название в SEO-спам из двадцати ключевых слов.
Название должно оставаться естественным.
Но из него должно быть понятно, что продаётся.
Характеристики становятся машинным языком каталога
Представим два описания.
Первое:
«Очень лёгкая и удобная модель с хорошей автономностью».
Второе содержит отдельные характеристики:
Вес: 245 г
Время работы: 32 часа
Bluetooth: 5.3
Активное шумоподавление: есть
Для человека оба варианта полезны.
Для автоматической обработки второй значительно ценнее.
Система может сравнить число с условием.
Покупатель просит:
«до 300 граммов»
или:
«работает больше суток».
Если данные существуют только внутри литературного описания, извлечь их можно, но это сложнее и менее надёжно.
Поэтому структурированные характеристики становятся основой современного товарного каталога.
Варианты товара тоже должны быть структурированы
Размер S и размер XL — не два совершенно разных товара.
Красный смартфон и тот же смартфон в чёрном цвете — варианты одной модели.
Но у вариантов могут различаться:
артикулы;
остатки;
изображения;
цена;
штрихкоды;
доступность.
Для внешней системы важно понимать эти связи.
Если все комбинации выгружаются как независимые товары без информации о родительской модели, каталог может превратиться в десятки почти одинаковых предложений.
Если, наоборот, варианты вообще не передаются, покупатель может увидеть товар как доступный, хотя нужный размер закончился.
Поэтому структура комбинаций внутри CMS напрямую влияет на качество внешнего каталога.
Цена должна совпадать с магазином
Одна из самых неприятных ошибок фида:
в поиске товар стоит 5 490 ₽,
покупатель переходит на сайт,
а там уже 6 190 ₽.
Даже если причина — задержка обновления, для покупателя это выглядит как обман.
Поэтому цена в фиде должна формироваться по той же логике, что и на сайте.
Особенно внимательно нужно работать с:
акциями;
специальными ценами;
комбинациями;
валютами;
налогами;
персональными ценами.
Если канал не поддерживает конкретный тип цены, нужно заранее определить, какую цену туда передавать.
Наличие должно быть реальным
Похожая ситуация возникает с остатками.
В каталоге магазина товар закончился.
Фид продолжает сообщать, что он доступен.
Внешняя площадка приводит покупателя на страницу, где купить ничего нельзя.
При большом каталоге такая проблема может затронуть тысячи товаров.
Поэтому фид желательно не собирать вручную раз в неделю.
Он должен автоматически формироваться из актуального каталога.
Для быстро меняющихся остатков может потребоваться более частое обновление или API.
Изображения — тоже данные
Фотография кажется исключительно визуальной частью карточки.
Но во внешнем каталоге изображение передаётся как URL.
Система должна иметь возможность открыть этот адрес и получить изображение.
Типичные проблемы:
ссылка доступна только после авторизации;
изображение удалили;
сервер блокирует внешние запросы;
передаётся миниатюра слишком низкого качества;
несколько товаров используют неправильную фотографию;
URL временный и перестаёт работать.
Поэтому изображения нужно проверять так же, как цену и наличие.
Особенно сейчас, когда изображения используются не только в товарной выдаче, но и в визуальном поиске.
Фид не заменяет микроразметку
Есть соблазн выбрать что-то одно:
либо фид, либо Schema.org.
Такой подход слишком упрощён.
У них разные задачи.
Микроразметка находится непосредственно на странице товара и помогает поисковым системам понять её содержимое.
Товарный фид передаёт каталог отдельным структурированным потоком.
Поэтому хороший интернет-магазин может одновременно иметь:
правильно оформленную карточку товара;
Product-разметку;
актуальный товарный фид.
Данные при этом должны совпадать.
Если в Schema.org указана одна цена, в YML другая, а на странице третья — количество технологий только увеличило проблему.
Главный принцип — один источник правды
Чем больше каналов использует магазин, тем опаснее редактировать каждый отдельно.
Представим каталог из 20 000 товаров.
Цена хранится:
на сайте;
в рекламном кабинете;
в YML;
на маркетплейсе;
в мобильном приложении.
Если обновлять всё вручную, расхождения неизбежны.
Правильная архитектура работает иначе.
Есть основной источник товарных данных.
Например, интернет-магазин или связанная с ним учётная система.
Из него данные автоматически отправляются дальше.
Каталог → фид → внешние сервисы.
Или:
учётная система → интернет-магазин → фиды и API → внешние каналы.
Тогда изменение цены происходит один раз.
Остальные системы получают обновление автоматически.
Особенно важен фид для большого каталога
Когда в магазине 30 товаров, многое ещё можно проверить вручную.
Когда их 30 000 — уже нет.
А если у каждого товара пять комбинаций, фактически приходится работать с сотнями тысяч состояний.
В большом каталоге особенно важны:
автоматическая генерация;
стабильные ID;
категории;
характеристики;
производители;
комбинации;
контроль ошибок;
регулярное обновление;
логирование.
Поэтому товарный фид становится частью архитектуры магазина, а не одноразовой выгрузкой.
Как это выглядит в PrestaShop
PrestaShop уже хранит большую часть необходимых данных структурированно.
У товара есть:
название;
описание;
цена;
категории;
производитель;
изображения;
характеристики;
атрибуты;
комбинации;
остатки;
артикул;
EAN/GTIN и другие данные.
Это хорошая база для автоматического формирования фидов.
Модуль может получать данные непосредственно из каталога и формировать нужный формат для конкретного канала.
Например:
YML для сервисов Яндекса;
XML или CSV для другой системы;
API для собственной интеграции;
отдельный формат для маркетплейса.
При этом не нужно вести несколько каталогов вручную.
Но автоматическая выгрузка не означает «установил и забыл»
Фид нужно контролировать.
Полезно регулярно проверять:
сколько товаров выгружается;
сколько отклонено;
есть ли товары без изображения;
совпадают ли цены;
есть ли позиции без категории;
не пропали ли характеристики;
корректно ли передаются комбинации;
обновляется ли файл по расписанию.
Особенно важны резкие изменения.
Вчера в фиде было 18 000 товаров.
Сегодня — 2 300.
Это повод не ждать жалоб покупателей, а сразу проверить генерацию.
Что проверить в каталоге уже сейчас
Для базового аудита не нужны сложные инструменты.
Возьмите десять разных товаров.
Не десять самых красивых, а разных:
простой товар;
товар с комбинациями;
товар со скидкой;
товар без остатка;
товар с несколькими изображениями;
товар с характеристиками.
И проверьте:
Есть ли у каждого понятное название?
Заполнен ли производитель?
Есть ли артикул?
Есть ли характеристики отдельными полями?
Правильно ли устроены варианты?
Совпадает ли цена?
Корректно ли определяется наличие?
Открываются ли изображения напрямую?
Есть ли правильная категория?
Стабилен ли идентификатор?
Если проблемы обнаруживаются уже на десяти товарах, в каталоге из нескольких тысяч они почти наверняка масштабируются.
Качественный каталог становится конкурентным преимуществом
Долгое время товарные данные воспринимались как техническая часть интернет-магазина.
Главное — чтобы карточка выглядела красиво.
Теперь ситуация меняется.
Один и тот же каталог используется всё большим количеством систем.
Поиск.
Реклама.
Маркетплейсы.
Мобильное приложение.
Рекомендации.
Визуальный поиск.
AI-помощники.
Чем лучше структурированы исходные данные, тем легче подключать новые каналы.
И наоборот: хаотичный каталог превращает каждую новую интеграцию в отдельный проект по очистке данных.
Как это связано с Ewonta
В основе интернет-магазинов Ewonta используется PrestaShop, поэтому каталог остаётся полноценной структурированной частью магазина, а не набором визуальных блоков конструктора.
Товары, категории, характеристики, комбинации, изображения, цены и остатки можно использовать не только на витрине, но и в интеграциях.
Это особенно важно для бизнеса, который развивается сразу в нескольких направлениях:
собственный интернет-магазин;
маркетплейсы;
мобильное приложение;
учётная система;
поисковые сервисы;
AI-инструменты.
В такой архитектуре сайт перестаёт быть изолированной витриной.
Он становится частью общей системы товарных данных.
Что изменилось на самом деле
Товарные фиды существуют далеко не первый год.
Новое заключается не в самом XML.
Изменилось количество систем, которым нужны данные каталога.
Раньше интернет-магазин мог думать:
«Нужно сделать фид для рекламы».
Теперь полезнее мыслить иначе:
«Нужно построить качественный каталог, который можно передать в любой канал».
Сегодня это Яндекс и рекламная система.
Завтра — маркетплейс.
Потом — мобильное приложение.
Следом — AI-поиск.
И если каждый новый канал требует вручную переделывать весь каталог, проблема находится не в канале.
Проблема находится в данных.
Поэтому один из важных технических активов современного интернет-магазина — не только дизайн и не только позиции в поиске.
Это чистый, структурированный и постоянно актуальный каталог, который одинаково хорошо понимают покупатели, поисковые системы и машины.